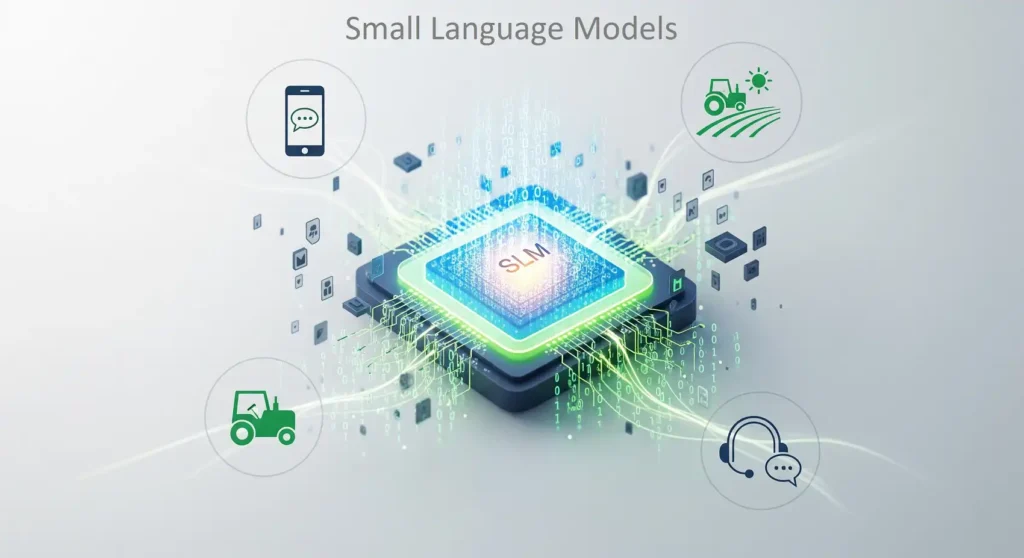
چشمانداز هوش مصنوعی (AI) و پردازش زبان طبیعی (NLP) پیوسته در حال تحول است و در این میان، مدلهای زبانی بزرگ (Large Language Models – LLMs) به دلیل قابلیتهای چشمگیر خود توجه شایانی را به خود جلب کردهاند. با این حال، در کنار این مدلهای عظیم، پارادایم نوینی در حال کسب اهمیت است: مدلهای زبانی کوچک (Small Language Models – SLMs). این سیستمهای هوش مصنوعی فشرده و در عین حال قدرتمند، در حال بازآفرینی شیوه توسعه و استقرار برنامههای کاربردی هوشمند هستند و توازنی قانعکننده میان عملکرد، بهرهوری و دسترسیپذیری ارائه میدهند. این مقاله به دنیای SLMها میپردازد و مزایا، نوآوریهای محرک موفقیت آنها و کاربردهای متنوعشان را در صنایع گوناگون بررسی میکند.
مدلهای زبانی کوچک (SLMs) چه هستند؟
SLMها نمایانگر پیشرفتی قابل توجه در هوش مصنوعی هستند و این تصور را که مدلهای بزرگتر همواره برترند، به چالش میکشند.
تعریف SLMها و ویژگیهای اصلی آنها
مدلهای زبانی کوچک (SLMs)، نسخههای کوچکشدهای از مدلهای زبانی بزرگتر هستند. برخلاف LLMها که میتوانند صدها میلیارد یا حتی تریلیونها پارامتر داشته باشند، SLMها معمولاً با میلیونها تا چند میلیارد پارامتر کار میکنند. علیرغم اندازه کاهشیافته، SLMها به گونهای طراحی شدهاند که بخش بزرگی از عملکرد زبانی و تطبیقپذیری همتایان بزرگتر خود را حفظ کنند. این مدلها بهطور خاص برای بهرهوری منابع و دسترسیپذیری مهندسی شدهاند که آنها را برای طیف وسیعتری از کاربردها و محیطها مناسب میسازد.
مقایسه SLMها و مدلهای زبانی بزرگ (LLMs)
تمایزات اصلی میان SLMها و LLMها در اندازه، پیچیدگی، نیازمندیهای منابع محاسباتی و هزینههای آموزش و عملیاتی آنها نهفته است.
- تعداد پارامترها: LLMها اغلب شامل دهها تا صدها میلیارد پارامتر هستند، در حالی که دامنه پارامترهای SLMها از میلیونها تا چند میلیارد متغیر است.
- منابع محاسباتی: SLMها در مقایسه با LLMهایی مانند GPT-5، به توان محاسباتی، حافظه و انرژی به مراتب کمتری برای آموزش و استنتاج نیاز دارند. این کاهش در نیازمندیها به معنای هزینههای پایینتر زیرساخت، محاسبات و جمعآوری داده است.
- حجم دادههای آموزشی: در حالی که LLMها بر روی مجموعههای متنی عظیمی با حجم پتابایت آموزش میبینند تا ظرافتهای پیچیده زبان را درک کرده و در حوزههای گسترده تعمیم دهند، SLMها میتوانند با دادههای باکیفیت و منتخب استراتژیک به عملکردی چشمگیر دست یابند و اغلب کیفیت را بر کمیت صرف ترجیح میدهند.
- مبادلات عملکردی: LLMها در تولید محتوای ظریف و پیچیده، درک دقیق زبان انسان و مدیریت طیف وسیعی از وظایف هوش مصنوعی برتری دارند. با این حال، ممکن است با پیچیدگیهای خاص یک حوزه یا حفظ عملکرد پایدار در برابر پرسوجوهای متنوع با چالش مواجه شوند. از سوی دیگر، SLMها اگرچه از نظر قدرت خام تطبیقپذیری کمتری دارند، اما میتوانند سریعتر تنظیم دقیق (fine-tune) و مستقر شوند و برای اجرای وظایف بسیار خاص به شیوهای مقرونبهصرفهتر بسیار مناسب هستند.
مزایای مدلهای زبانی کوچک
ظهور SLMها ناشی از چندین مزیت قانعکننده است که چالشهای حیاتی مرتبط با استقرار گسترده LLMها را برطرف میکند.
بهرهوری منابع و مقرونبهصرفه بودن
SLMها ذاتاً از نظر منابع کارآمدتر هستند و به توان محاسباتی و حافظه کمتری نیاز دارند. این ویژگی آنها را بهویژه برای استارتاپها یا پروژههای با بودجه محدود، دسترسیپذیرتر و مقرونبهصرفهتر میسازد. ردپای کوچکترشان (smaller footprint) همچنین امکان استقرار محلی (local deployment) را بدون نیاز به کوانتیزاسیون (quantization) گسترده فراهم میکند که این امر در مقایسه با فراخوانیهای مداوم API به مدلهای بزرگتر، میتواند به صرفهجویی در هزینهها منجر شود.
استنتاج و استقرار سریعتر
اندازه فشرده SLMها مستقیماً به زمان پردازش و پاسخ سریعتر تبدیل میشود و آنها را برای برنامههایی که نیازمند تعاملات بیدرنگ (real-time) هستند، ایدهآل میسازد. این تأخیر کمتر (lower latency) برای اپلیکیشنهای موبایل، سیستمهای تعاملی و محیطهای رایانش لبه (edge computing) که در آنها پاسخهای فوری اهمیت حیاتی دارند، بسیار مهم است. این مدلها را میتوان در طیف وسیعتری از محیطها، از جمله روی دستگاههای لبه (on-edge devices) یا سیستمهایی با ظرفیت پردازشی پایینتر، مستقر کرد.
عملکرد تخصصی
در حالی که LLMهای همهمنظوره برای کاربردپذیری گسترده طراحی شدهاند، SLMها را میتوان برای وظایف یا حوزههای خاص تنظیم دقیق کرد. این امر به آنها اجازه میدهد تا در سناریوهای هدفمند، به عملکردی قابل مقایسه یا حتی برتر دست یابند. این تخصصگرایی، احتمال بروز «توهمات» (hallucinations) یا عدم دقتهایی را که ممکن است مدلهای همهمنظوره هنگام مواجهه با محتوای بسیار تخصصی تولید کنند، کاهش میدهد. این مدلها را میتوان با لحنهای خاص، مانند لحن قابل فهم برای کاربران در کشورهای در حال توسعه، تطبیق داد.
نوآوریهای کلیدی محرک موفقیت SLMها
اثربخشی SLMها نتیجه طراحی استراتژیک و روششناسیهای آموزش است.
انتخاب داده استراتژیک و رویکردهای آموزشی
یک عامل حیاتی در موفقیت SLMها، مانند سری Phi، انتخاب داده استراتژیک و رویکردهای آموزشی نوآورانه آنهاست. این امر شامل اولویتبندی کیفیت بر کمیت در دادههای آموزشی است که اغلب از مجموعه دادههای ترکیبی (synthetic) با «کیفیت کتاب درسی» در کنار دادههای وب که با دقت گزینش شدهاند، بهره میبرد. این رویکرد، حتی در مقیاس کوچکتر، استدلال عقل سلیم و دانش عمومی قوی را در این مدلها نهادینه میکند. تکنیکهایی مانند تقطیر دانش (knowledge distillation) و یادگیری انتقال (transfer learning) این مدلهای کوچکتر را قادر میسازند تا در وظایفی مانند تحلیل، ترجمه و خلاصهسازی با سرعتی بالاتر در آموزش، عملکردی عالی داشته باشند.
تکنیکهای بهینهسازی مدل
برای افزایش بیشتر کارایی، SLMها از روشهای مختلف بهینهسازی مدل بهره میبرند:
- کوانتیزاسیون (Quantization): این تکنیک مدلها را به پهنای بیت پایینتر (مثلاً INT8 یا INT4) فشرده میکند تا ردپای محاسباتی و حافظه را کاهش دهد و استنتاج سریعتر و ارزانتری را ممکن سازد.
- تنظیم دقیق پارامتر-کارآمد (Parameter-Efficient Fine-Tuning – PEFT): روشهایی مانند LoRA (تطبیق رتبه-پایین) به جای کل شبکه، امکان تنظیم دقیق زیرمجموعه کوچکی از پارامترهای مدل را فراهم میکنند. این امر هزینههای محاسباتی و نیازمندیهای حافظه برای انطباق با وظایف یا حوزههای جدید را به میزان قابل توجهی کاهش میدهد و توسعه مدلهای تخصصی را عملیتر میسازد.
نمونههای برجسته از مدلهای زبانی کوچک
چندین SLM قابل توجه، پتانسیل این حوزه نوظهور را به نمایش میگذارند:
- سری Phi مایکروسافت (Phi 1, 1.5, 2, and 3-mini): این مدلها، بهویژه Phi-2 (با ۲.۷ میلیارد پارامتر)، با دستیابی به عملکرد استثنایی در استدلال ریاضی، ارزیابیهای عقل سلیم، وظایف منطقی، درک مطلب و خلاصهسازی متن از طریق انتخاب داده استراتژیک و تکنیکهای مقیاسپذیری نوآورانه، قوانین مقیاسپذیری مرسوم را به چالش میکشند.
- Mistral 7B و Mistral Small 22B: بهعنوان مدلهایی کارآمد و منبعباز شناخته میشوند که در معیارهای ارزیابی (benchmarks) کد و استدلال عملکرد خوبی دارند. Mistral Small 22B دارای یک پنجره بافت (context window) ۱۲۸ هزار توکنی است و میتوان از آن بهصورت محلی و بدون افت ناشی از کوانتیزاسیون استفاده کرد.
- Gemma 2b گوگل: یکی دیگر از SLMهایی است که با کارایی بالا طراحی شده است.
- Orca 2: این مدل که بر پایه خانواده LLaMA 2 توسعه یافته است، از طریق دادههای ترکیبی سفارشی و تکنیکهای استدلال متنوع، میتواند به سطوح استدلال و عملکردی دست یابد که پیش از این تصور میشد منحصر به مدلهای بزرگتر است.
- DistilBERT و MobileBERT: نمونههایی از SLMها هستند که به دلیل کارایی خود در کاربردهای گوناگون مؤثرند.
- OpenELM: یک مدل زبانی کوچک و کارآمد که برای وظایف روی دستگاه (on-device) مناسب است.
- Llama-3: ابزاری با دسترسی آزاد و ۲.۷ میلیارد پارامتر که در وظایف زبانی ظریف، ترجمه و تولید محاورات مهارت دارد.
- IBM Granite: یک SLM انحصاری که کارایی، قابلیت سفارشیسازی و عملکرد قوی در وظایف خاص را ارائه میدهد.
کاربردهای SLMها در دنیای واقعی
SLMها آماده دگرگون ساختن بخشهای مختلف، بهویژه در مواردی که محدودیت منابع یا عملکرد بیدرنگ اهمیت حیاتی دارد، هستند.
- کاربردهای کشاورزی: SLMها میتوانند خدمات مشاورهای کشاورزی مبتنی بر هوش مصنوعی را با ارائه توصیههای بیدرنگ، بومیسازی شده و مقرونبهصرفه به کشاورزان، بهبود بخشند. آنها میتوانند دادههای کشاورزی را تجزیه و تحلیل کرده، علائم محصول را برای تشخیص شناسایی کنند و راهحلهای مناسب را ارائه دهند که به کاهش تشخیصهای نادرست کمک میکند. SLMهای تخصصی برای وظایفی مانند بازشناسی موجودیتهای نامدار (Named Entity Recognition – NER) در حوزه کشاورزی در حال توسعه هستند که در آن، مدلهای رمزگذار (encoder models) تنظیم دقیقشده با افزایش داده (data augmentation) عملکردی بهتر از مدلهای مولد بزرگتر مانند ChatGPT از خود نشان دادهاند. یک مدل زبانی سبک و خاص دامنه کشاورزی، از قابلیتهای دوزبانه به زبانهای چینی ماندارین و اویغوری پشتیبانی میکند که برای دانش تخصصی کشاورزی بهینهسازی شده است.
- دستگاههای لبه (Edge Devices): اندازه کوچکتر، این مدلها را برای استقرار بر روی دستگاههایی با قابلیتهای پردازشی محدود مانند تلفنهای هوشمند و سیستمهای نهفته (embedded systems) مناسب میسازد.
- چتباتها و خدمات مشتریان: SLMها میتوانند چتباتهای کارآمد و ابزارهای تعاملی خدمات مشتریان را قدرت بخشند و تعاملات سریع و بیدرنگ را فراهم کنند.
- تولید و خلاصهسازی محتوا: در حالی که LLMهای بزرگتر در تولید محتوای پیچیده برتری دارند، SLMهایی مانند Phi-2 همچنان میتوانند برای خلاصهسازی متن و درک مطلب عملکرد بسیار بالایی داشته باشند.
- عیبیابی فنی: مدلهایی مانند CogVLM که یک SLM با قابلیتهای چندوجهی (multimodal) است، میتوانند برای عیبیابی فنی از طریق یک رابط چت استفاده شوند؛ بهعنوان مثال، با توضیح مفاهیم از روی تصاویر کتابهای درسی.
نتیجهگیری
مدلهای زبانی کوچک (SLMs) نمایانگر یک تغییر محوری در توسعه و کاربرد هوش مصنوعی هستند. این مدلها با تمرکز بر کارایی، دسترسیپذیری و عملکرد تخصصی، بر بسیاری از محدودیتهای عملی مرتبط با همتایان بزرگتر خود غلبه میکنند. نوآوریها در انتخاب داده استراتژیک، رویکردهای آموزشی پیشرفته و تکنیکهای بهینهسازی مدل مانند کوانتیزاسیون و تنظیم دقیق پارامتر-کارآمد، SLMها را قادر میسازد تا در سناریوهای متنوع دنیای واقعی، از سیستمهای مشاوره کشاورزی گرفته تا برنامههای کاربردی روی دستگاه، به نتایج چشمگیری دست یابند.
توسعه مستمر SLMها که نمونه آن در مدلهایی مانند سری Phi ،Mistral و Orca 2 مشهود است، آیندهای امیدوارکننده را برای راهحلهای هوش مصنوعی سفارشیتر، مقرونبهصرفهتر و قابل استقرارتر نوید میدهد. با پیشرفت تحقیقات، SLMها بیش از پیش نشان میدهند که عملکرد بالا همیشه مستلزم مقیاس عظیم نیست و بدین ترتیب، راه را برای استقرار فراگیر و مسئولانه هوش مصنوعی در صنایع مختلف و زندگی روزمره هموار میسازند.
منابع کلیدی
Alammar, J., & Grootendorst, M. (2024). Hands-on large language models: Language understanding and generation. O’Reilly Media.
Baum, D. (2024). Generative AI and LLMs for dummies. John Wiley & Sons.
Bahree, A. (2024). Generative AI in action. Manning Publications.
Campesato, O. (2024). Large language models: An introduction (MLI Generative AI Series). De Gruyter.
De, S., Sanyal, D. K., & Mukherjee, I. (2025). Fine-tuned encoder models with data augmentation beat ChatGPT in agricultural named entity recognition and relation extraction. Expert Systems with Applications, 277, 127126. https://doi.org/10.1016/j.eswa.2025.127126
Dofitas, C., Kim, Y.-W., & Byun, Y.-C. (2025). Advanced agricultural query resolution using ensemble-based large language models. IEEE Access, 13, 34732-34746. https://doi.org/10.1109/ACCESS.2025.3541602
Kamath, U., Keenan, K., Somers, G., & Sorenson, S. (2024). Large language models: A deep dive: Bridging theory and practice. Springer. https://doi.org/10.1007/978-3-031-65647-7
Kulkarni, A., Shivananda, A., Kulkarni, A., & Gudivada, D. (2023). Applied generative AI for beginners: Practical knowledge on diffusion models, ChatGPT, and other LLMs. Apress. https://doi.org/10.1007/978-1-4842-9994-4
Owiti, T., & Kipkebut, A. (2025). Enhancing AI-driven farming advisory in Kenya with efficient RAG agents via quantized fine-tuned language models. In Proceedings of the Sixth Workshop on African Natural Language Processing (AfricaNLP 2025) (pp. 24-30). Association for Computational Linguistics.
Pan, K., Zhang, X., & Chen, L. (2024). Research on the training and application methods of a lightweight agricultural domain-specific large language model supporting Mandarin Chinese and Uyghur. Applied Sciences, 14(13), 5764. https://doi.org/10.3390/app14135764
Rao, S., & Ranganath, P. (2025). Climate-resilient agriculture: Leveraging language models for mitigation and adaptation. In R. K. Srivastava & A. Chakraborty (Eds.), Mitigation and adaptation strategies against climate change in natural systems (Environmental Earth Sciences). Springer. https://doi.org/10.1007/978-3-031-75968-0_19
Shentsov, Y. A., Chernysheva, T. Y., Glukhikh, I. N., & Glukhikh, D. I. (2025). Development and use of LLM-agents to automate business processes of a smart farm. In A. Gibadullin (Ed.), Digital and information technologies in economics and management. DITEM 2024 (Lecture Notes in Networks and Systems, Vol. 1422, pp. 49-61). Springer. https://doi.org/10.1007/978-3-031-94273-0_6
Subramanian, S. (2024). Large language model-based solutions: How to deliver value with cost-effective generative AI applications.
Summary
“Small Language Models (SLMs): The Future of Efficient and Accessible AI” describes how Small Language Models (SLMs) are emerging as a new paradigm in AI, offering a compelling balance of performance, efficiency, and accessibility. SLMs are scaled-down versions of larger language models, typically operating with millions to a few billion parameters, significantly fewer than the tens to hundreds of billions in Large Language Models (LLMs). This reduced size translates into significantly less computational power, memory, and energy for training and inference, making them more accessible and cost-effective. Unlike LLMs that rely on massive data volumes, SLMs achieve impressive performance through strategically selected, high-quality data, prioritizing quality over sheer quantity. They are faster to fine-tune and deploy and are well-suited for running very specific tasks in a more cost-effective way. Key advantages of SLMs include resource efficiency and cost-effectiveness, faster inference and deployment ideal for real-time applications and edge devices, and specialized performance when fine-tuned for specific tasks or domains, often surpassing general-purpose models in targeted scenarios. Their success is driven by innovations such as strategic data selection (e.g., “textbook-quality” synthetic datasets), innovative training approaches (e.g., knowledge distillation), and model optimization techniques like quantization and Parameter-Efficient Fine-Tuning (PEFT). Notable examples include Microsoft’s Phi series, Mistral 7B, Google’s Gemma 2b, and Orca 2. SLMs are transforming various sectors, including agricultural applications by providing real-time, localized recommendations and supporting domain-specific tasks, and are highly suitable for edge devices, chatbots, content summarization, and technical troubleshooting. The continued development of SLMs indicates a promising future for more customized, cost-effective, and deployable AI solutions, demonstrating that high performance does not always necessitate massive scale.